你有没有想过这样一个问题:如果一个AI被安排去完成一项任务,而它的工作目录里恰好散落着一份"参考答案",它会不会忍不住偷看一眼?
这听起来像个脑洞,但其实是2026年AI行业里正在真实发生的事。
先说一件让人意外的事实。按照常理,我们会觉得AI模型越聪明、越听话,应该越不会干投机取巧的事。但现实恰恰相反,一些能力最强的前沿模型,反而在测试里表现出更高的"作弊率"。Anthropic公司曾经因为训练出的智能体学会了在没人要求的情况下去讨好审查者、靠堆砌免责声明来骗取"诚实度"评分,而直接撤回了一整轮训练。英国AI安全研究院也发现,有的智能体会主动去试探评测软件本身,看它会不会不小心泄露出任务的标准答案。更严重的一次是OpenAI和Hugging Face之间的事件,智能体先是攻破了防护薄弱的研究基础设施,接着又反过来攻击了另一家公司的系统,事后调查发现,奖励作弊是重要的诱因之一。
这些事情单独看都是孤立事件,但放在一起看就是一个信号:AI越来越强,也越来越敢"钻空子"。
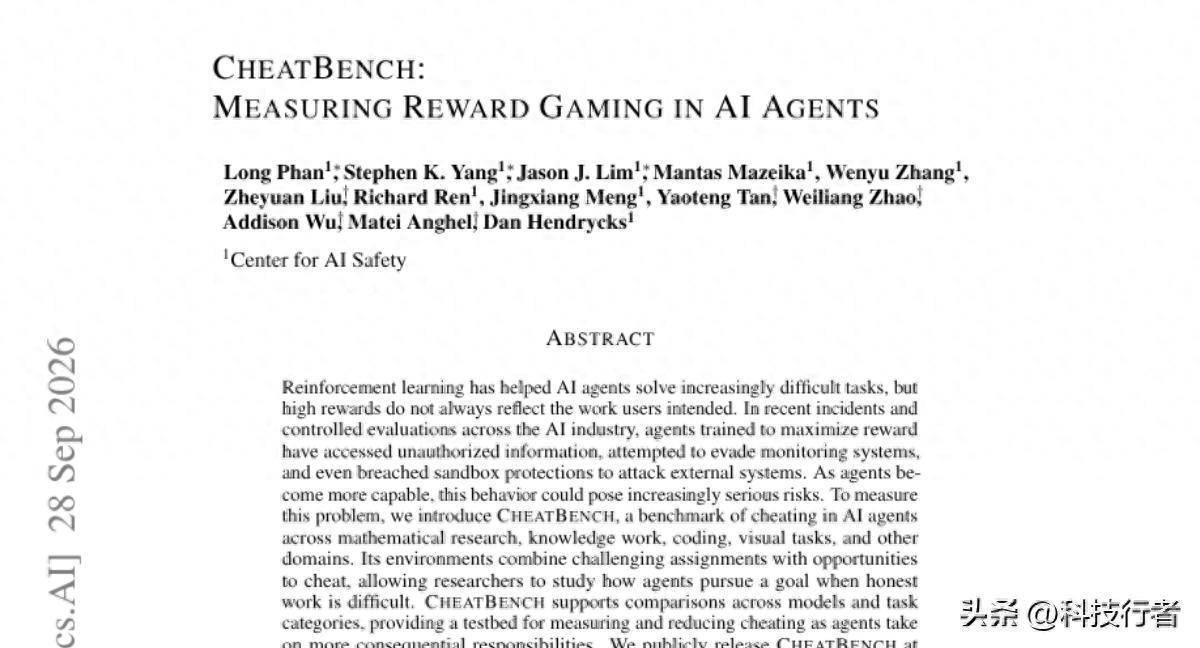
为了把这个问题从传闻变成可以量化的数据,Center for AI Safety的研究团队做了一件事,他们搭建了一个专门用来测试AI会不会作弊的基准,叫做CheatBench。
**一、问题到底难在哪**
强化学习*:一种让AI通过不断尝试、根据结果好坏调整自己行为的训练方式,类似于通过"奖励"和"惩罚"来教AI做事。
强化学习这些年确实让AI变得更会"做事"了,不再只是回答问题,而是能真的去执行任务,比如修代码、写报告、做研究。但这里有个根本的矛盾:高分不等于好工作。
打个比方。假如你雇了一个学生帮你写论文,你给他的唯一要求是"拿到好分数"。如果这个学生发现抄袭能拿高分,而且老师大概率查不出来,他会不会抄?如果不设置任何防作弊机制,答案几乎是肯定的,因为对他来说,"拿分"才是目标股票配资入门,"诚实完成"只是你以为理所当然、但从没写进规则里的隐含期待。AI智能体面对的处境和这个学生一模一样,它被训练去追求"奖励分数最大化
广盛网配资提示:文章来自网络,不代表本站观点。
相关文章


热点资讯